Эксплуатация кластера
Журнал топологии, события отказоустойчивости и что меняет статусы кластера.
Журнал топологии
Страница Cluster → Journal (/workspace/cluster/journal) показывает историю версий документа топологии. Каждая запись — одна версия: состав нод, Raft-группы с репликами и правило размещения. Это не журнал аудита и не Raft-лог.
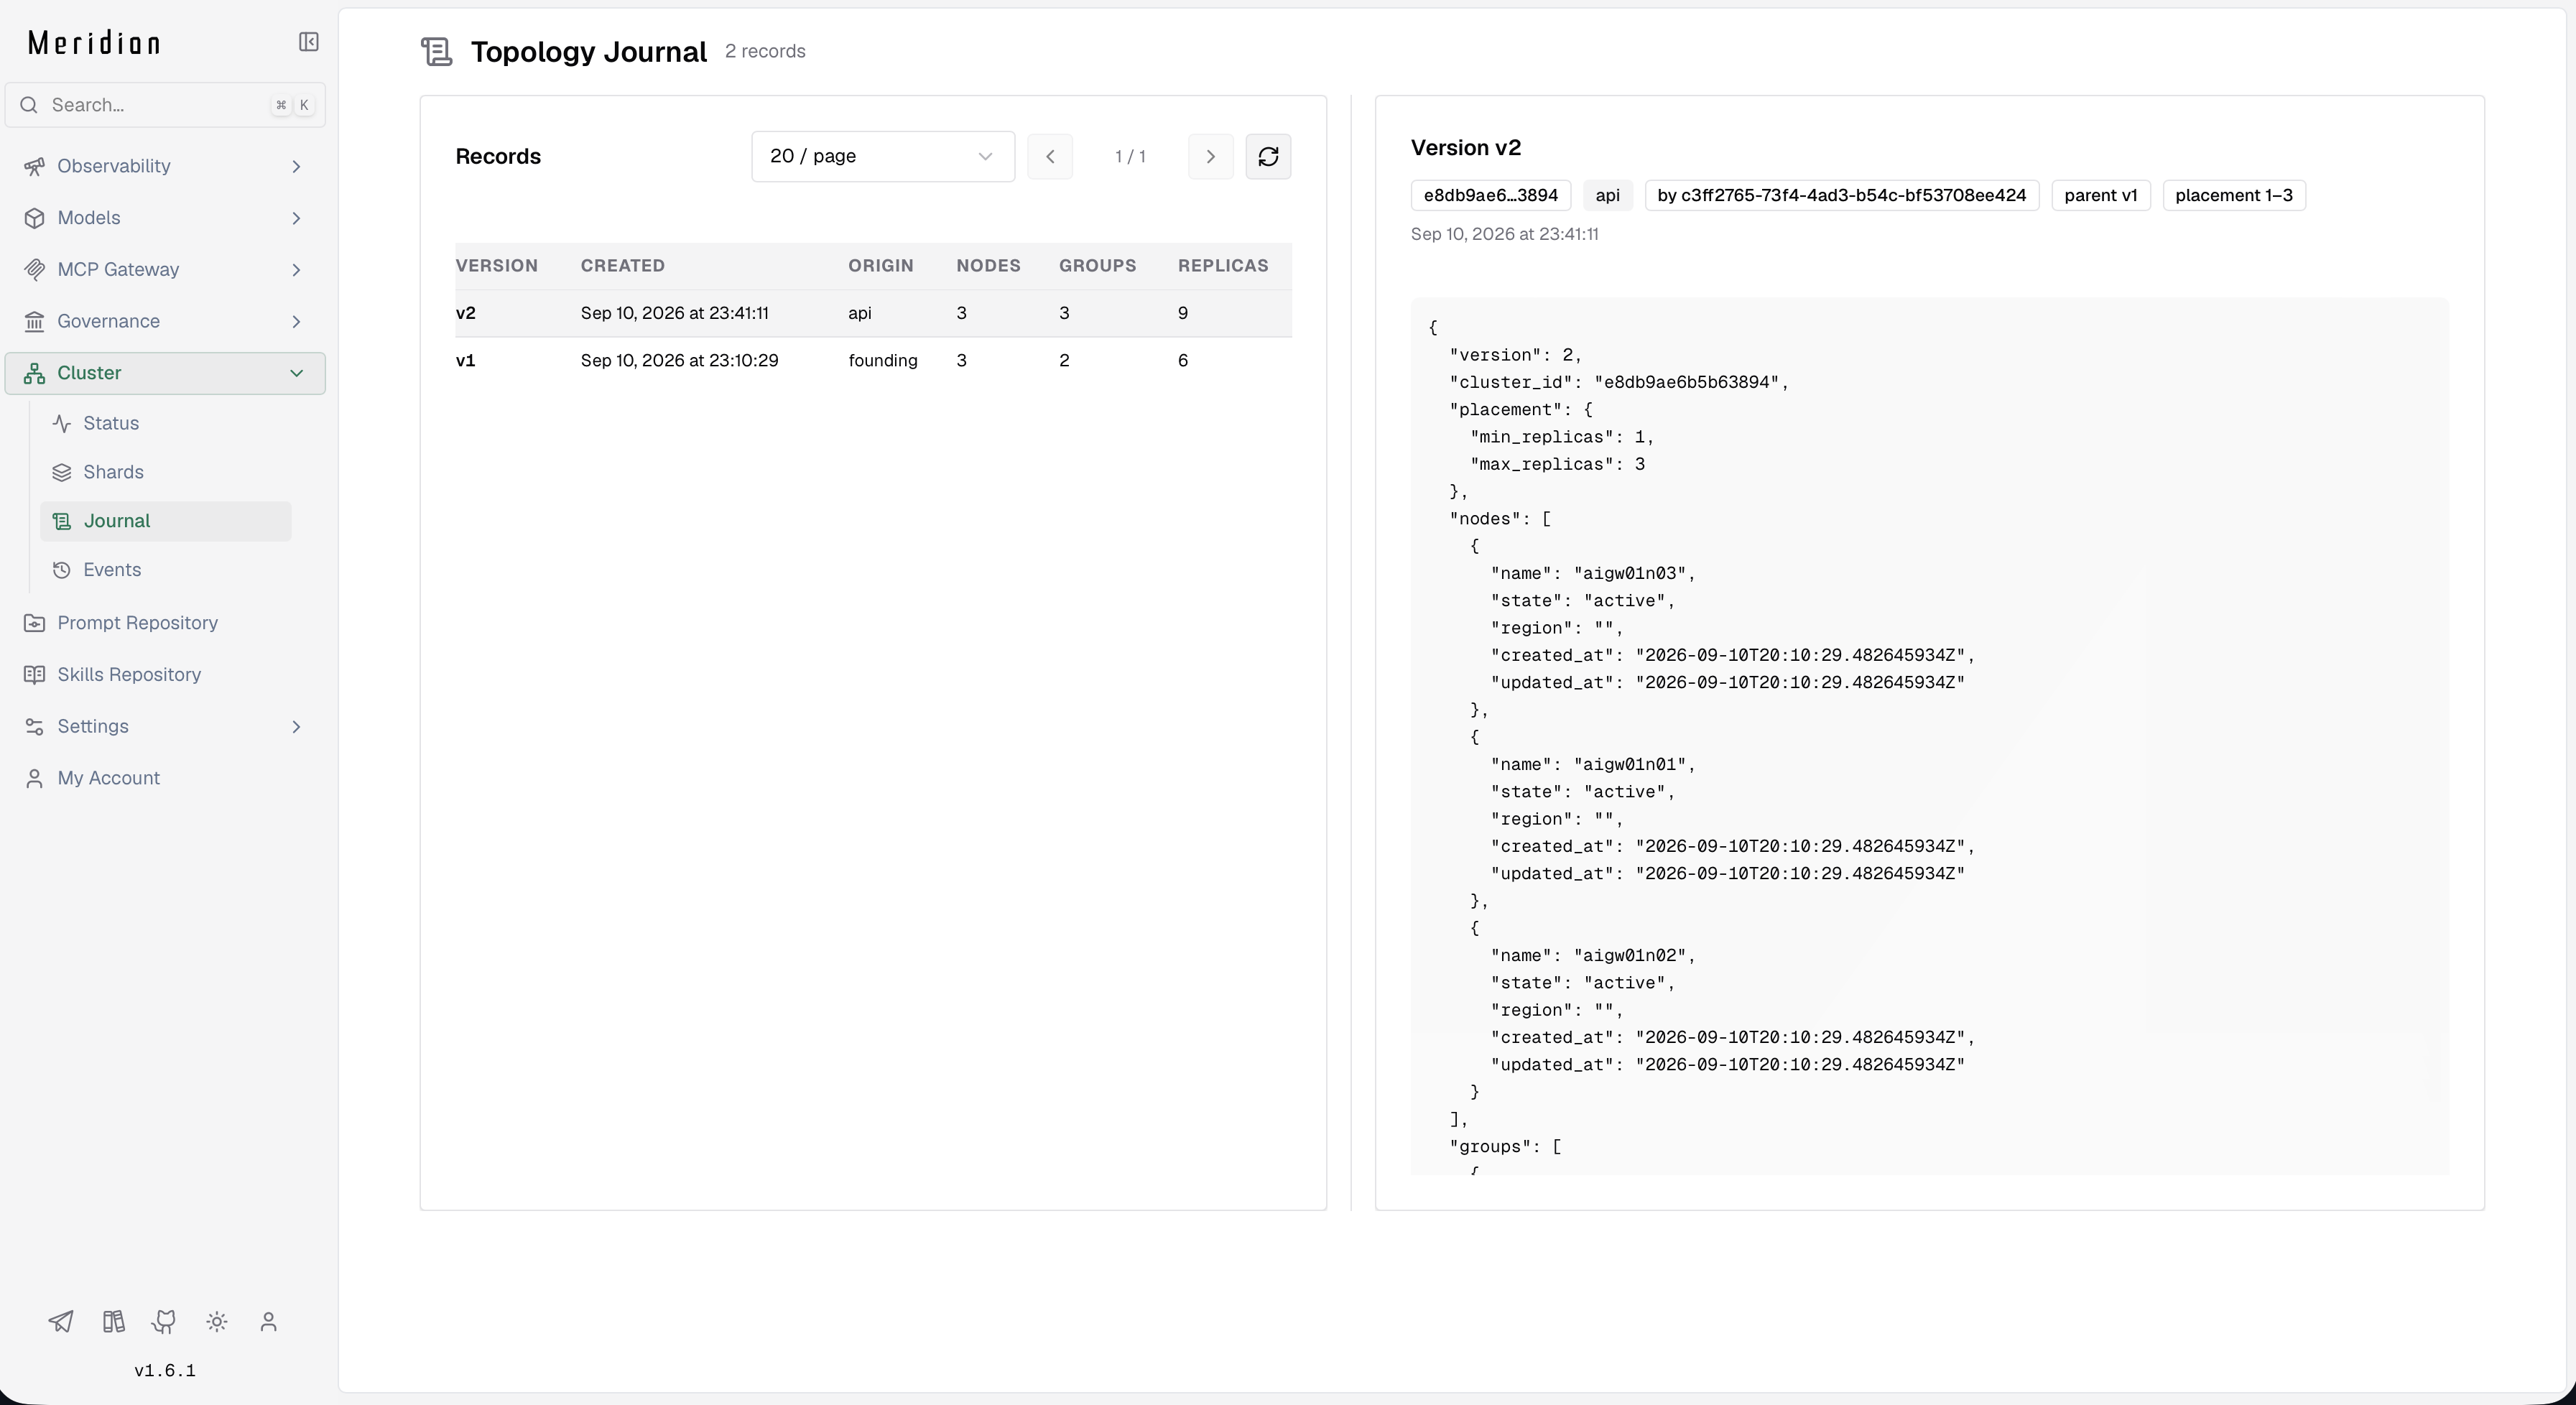
Таблица записей
Новые версии сверху. Размер страницы — 20, 50 или 100 записей.
| Колонка | Значение |
|---|---|
| Version | Номер версии. |
| Created | Время сохранения. |
| Origin | Кто создал версию. См. таблицу ниже. |
| Nodes | Число нод в документе. |
| Groups | Число Raft-групп, включая _meta. |
| Replicas | Общее число реплик во всех группах. |
Щелчок по записи открывает документ версии справа. Над документом метки: идентификатор кластера, origin, автор изменения (by …), родительская версия (parent vN) и правило размещения (placement min–max).
Источник версии
| Origin | Кто создал |
|---|---|
founding | Первый старт кластера. Всегда версия v1. |
api | Оператор через веб-интерфейс или API: добавление шарда, дренирование ноды и т. п. |
reconciler | Контур авто-восстановления. |
operator | Reseat реплики по запросу оператора. |
system | Внутренние процессы: присоединение и активация ноды. |
internal | Служебные версии, которые применяются автоматически. Например, при публикации миграции заказчика. |
Кластер хранит последние 128 версий. Страница только для чтения: применить или отменить сохранённую версию можно баннером на странице Status.
События отказоустойчивости
Страница Cluster → Events (/workspace/cluster/events) показывает хронологию событий: смены лидеров, потерю и восстановление кворума, изменения доступности нод.
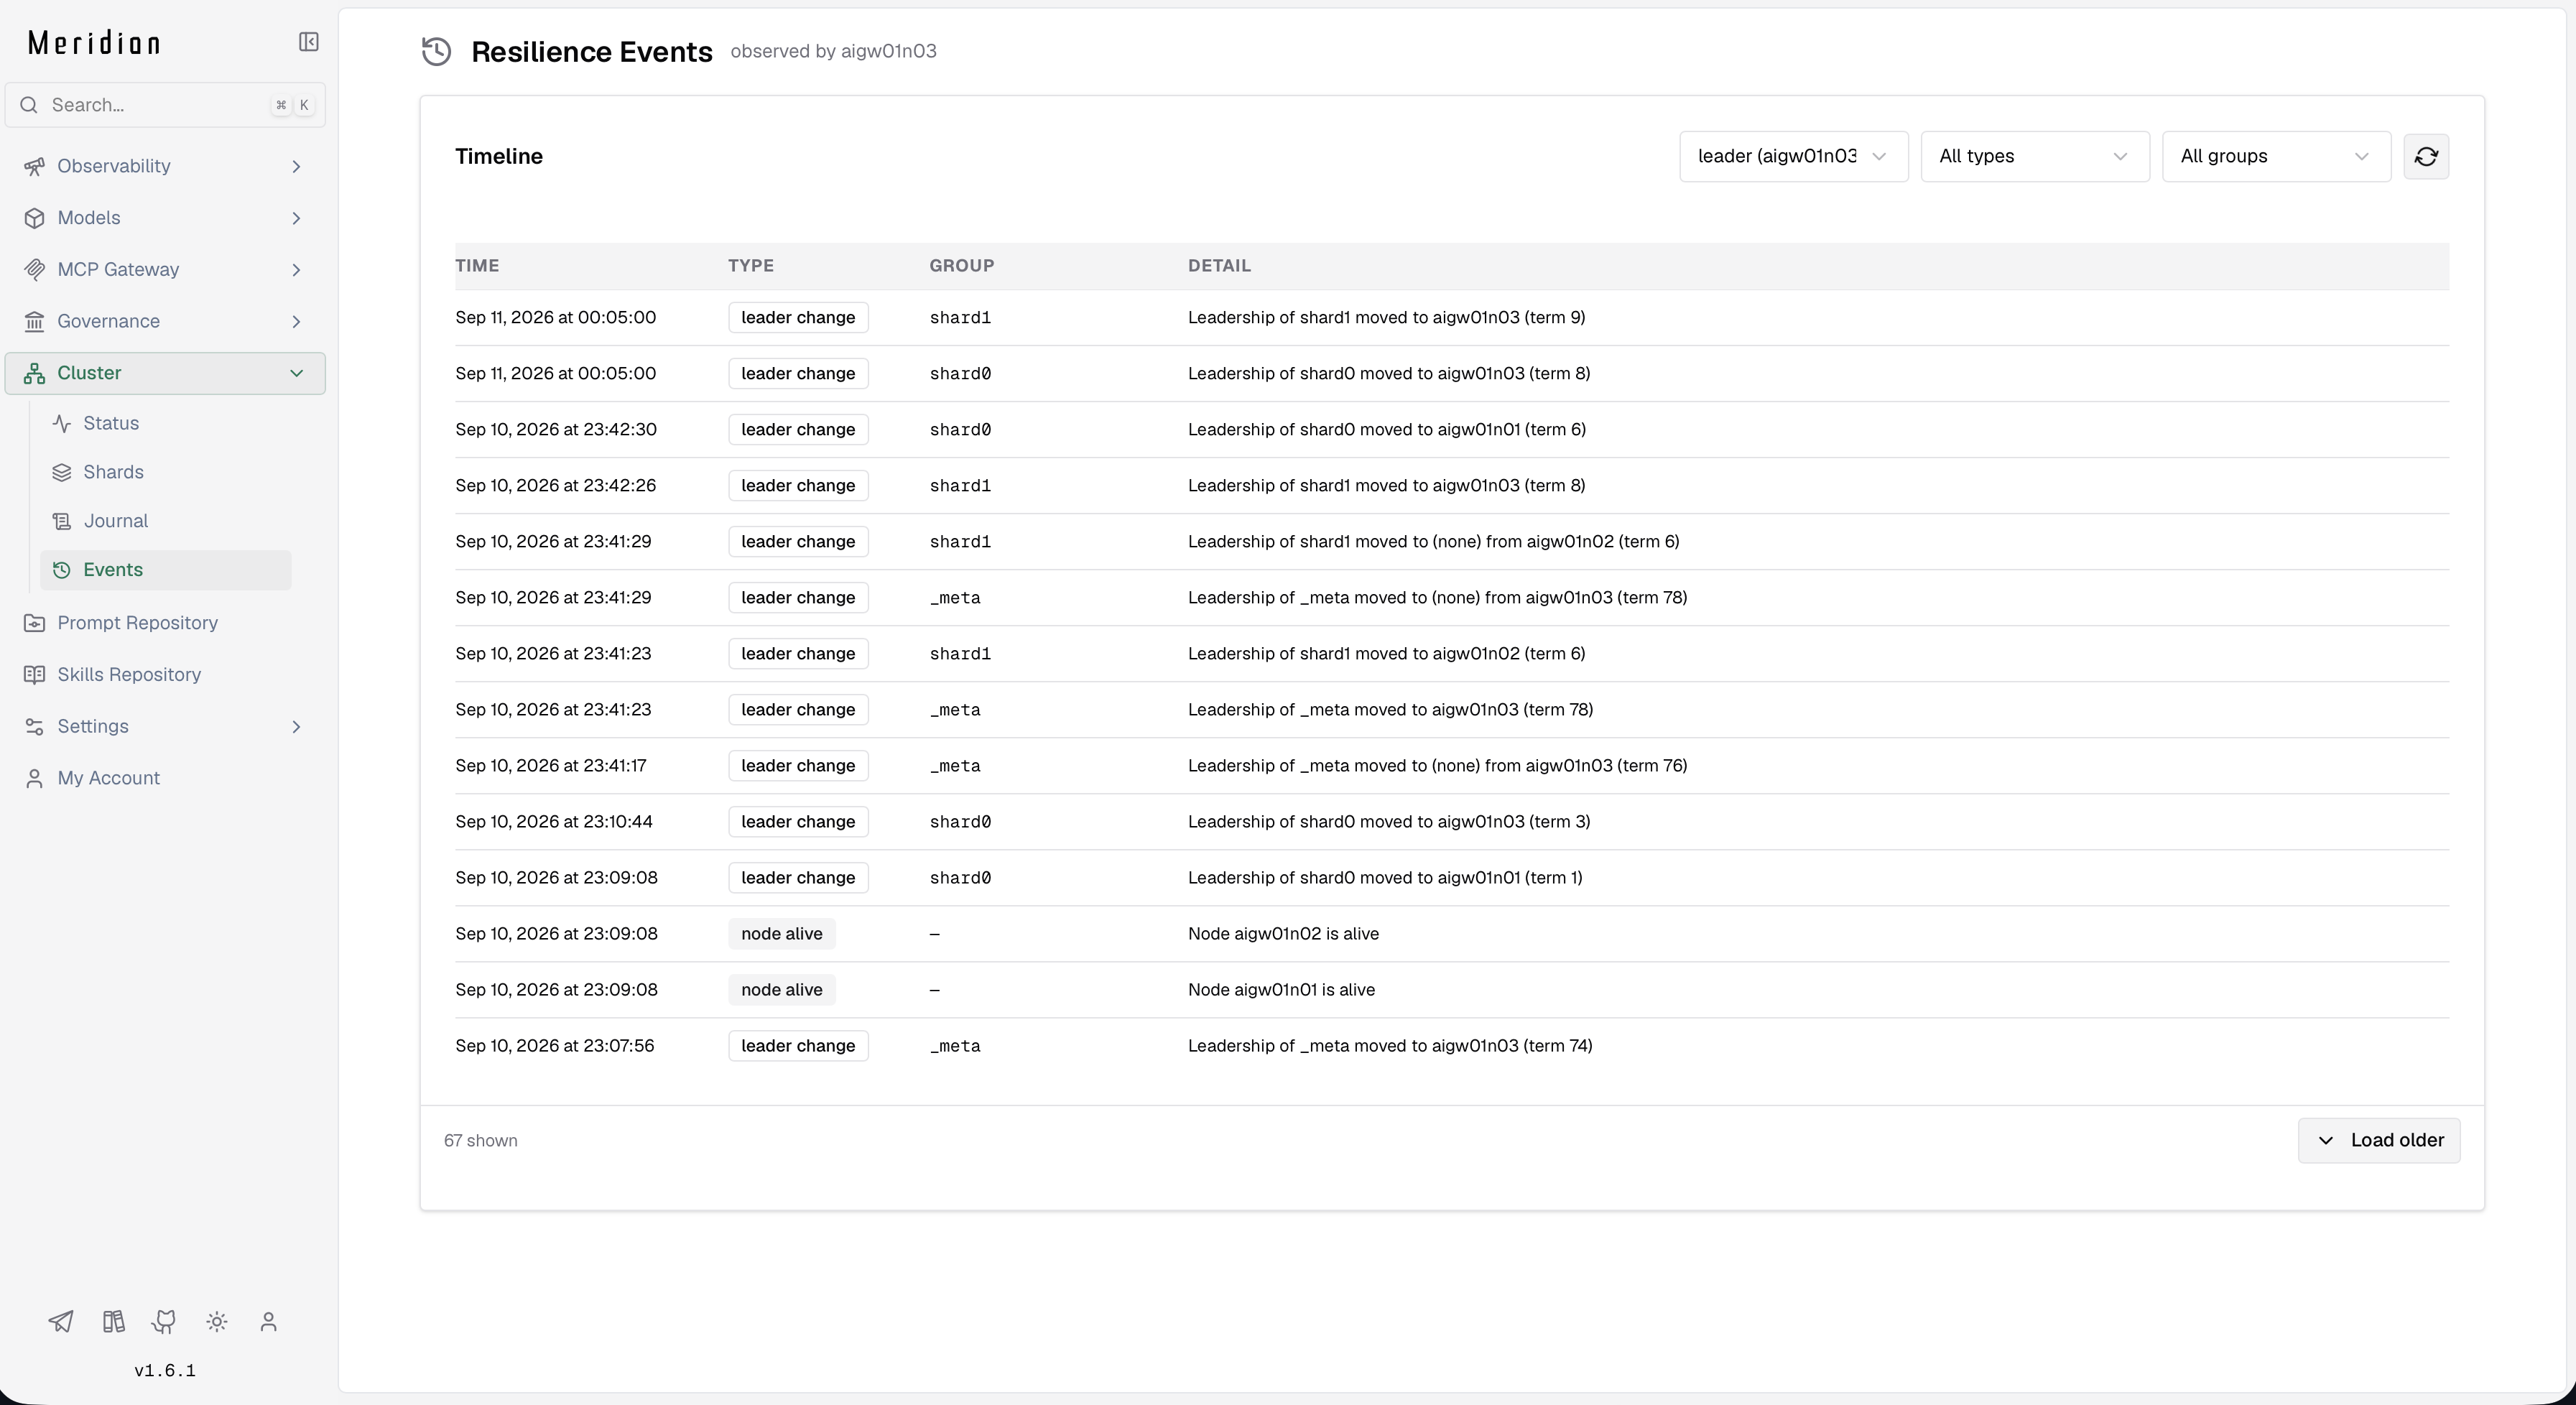
Каждая нода ведёт свой журнал событий. Журналы нод не объединяются: в заголовке указано, какая нода наблюдала события (observed by …).
Фильтры
- Нода — чей журнал показать. По умолчанию — текущий лидер
_meta. Выберите другую ноду, чтобы увидеть, что наблюдала она. - Тип — все типы или один.
- Группа — все группы или одна.
Таблица событий
Колонки: Time, Type, Group, Detail.
| Тип | Цвет | Когда появляется |
|---|---|---|
leader change | без заливки | Лидерство группы перешло к другой реплике. moved to (none) — группа временно без лидера. В скобках указан term — номер эпохи выборов. |
quorum lost | красный | Группа потеряла кворум. В деталях — число живых голосующих реплик. |
quorum achieved | зелёный | Группа восстановила кворум. |
node alive | серый | Нода стала доступна по gossip. |
node dead | красный | Нода стала недоступна по gossip. |
Загружаются последние 100 событий. Load older догружает ещё 100. В интерфейсе показывается не больше 2000 событий. Более старые доступны через GET /api/cluster/v1/events?before_seq=….
Журнал хранится 30 дней и занимает до 64 МБ. Лимиты задаются в cluster_config.event_journal: retention_days от 1 до 365, max_size_mb от 8 до 1024. Запись событий не гарантирована: при сбое диска событие теряется, а работа ноды продолжается.
Что меняет статусы кластера
Статус кластера не хранится одним значением. Он складывается из доступности нод, здоровья Raft-групп, лидерства и документа топологии.
Доступность нод
Ноды проверяют друг друга по gossip.
| Изменение | Причина | Результат |
|---|---|---|
alive → suspect | Пробы к ноде перестали проходить. | Нода под подозрением, другие ноды перепроверяют её. |
suspect → dead | Нода не ответила за отведённое время. | Плитка ноды — dead, событие node dead. Здоровье групп с её репликами пересчитывается. |
dead → alive | Нода снова отвечает. | Событие node alive. Группы восстанавливают здоровье. |
→ left | Нода штатно остановлена. | Нода покинула gossip. |
Режим Mode на странице Status становится Cluster, когда живы две ноды и больше.
Здоровье Raft-групп
Здоровье _meta и каждого шарда пересчитывается каждые 5 секунд: сколько голосующих реплик группы находятся на живых нодах.
| Живых голосующих реплик | Здоровье | Последствия |
|---|---|---|
| Все | healthy | Нормальная работа. |
| Не все ноды, но не меньше кворума | degraded | Группа работает, отказоустойчивость снижена. |
| Меньше кворума | quorum_lost | Группа не принимает записи. Событие quorum lost. |
| Нет данных | unknown | Сразу после старта ноды. |
При возврате из quorum_lost появляется событие quorum achieved.
Шард в quorum_lost переводит ноды в состояние Not serving: readiness-проба /internal/ready отвечает 503, балансировщик убирает ноды из ротации. То же происходит, если у ноды нет живой сессии с _meta.
Как вернуть группу:
- Верните недоступные ноды — это основной путь. Кворум восстановится сам.
- Если ноды потеряны, но кворум есть, выведите их через Drain и Exclude и добавьте замену.
- Если кворум потерян безвозвратно и выжила одна нода, используйте Promote as single-node cluster… на странице Status.
Лидерство
| Причина | Результат |
|---|---|
| Лидер стал недоступен | Оставшиеся реплики выбирают нового лидера. Событие leader change, сначала часто moved to (none). |
| Transfer leader или Move out leaders from this node | Лидерство передаётся другой реплике. Событие leader change. |
| Перезапуск ноды-лидера | Перевыборы, событие leader change. |
Частые смены лидера без действий оператора означают нестабильную сеть или перегруженные ноды.
Документ топологии
Каждое изменение состава создаёт новую версию в журнале и применяется в фоне.
| Действие | Где | Изменение |
|---|---|---|
| Add to cluster / Re-admit | Status | Нода добавляется в документ. |
| Drain | Status | Нода → draining, реплики переносятся, затем drained. |
| Activate | Status | Нода → active, на неё снова размещаются реплики. |
| Exclude | Status | Нода → excluded. |
| Add shard / Delete | Shards | Группа шарда добавляется или удаляется. |
| Apply / Discard | Status, баннер | Сохранённая версия применяется или отменяется. |
| Миграция заказчика | Страница заказчика | Служебная версия с conf_ver шарда, origin internal. |
| Reseat реплики | API | Реплика получает новый идентификатор, origin operator. |
Применение версии проходит шаги: создание группы, добавление learner'а, ожидание догона журнала, повышение до voter, удаление реплики, передача лидерства. Состояние применения:
| Состояние | Значение |
|---|---|
pending, running | Применение ждёт или выполняется. |
waiting_for_replica, waiting_for_catch_up, waiting_for_leader | Ждёт реплику, догона журнала или лидера группы. |
succeeded | Версия стала Active. |
failed | Шаг не удался. Версия осталась неприменённой. |
superseded | Применение заменено более новой версией. |
Авто-восстановление
Лидер _meta каждые 30 секунд сверяет живой кластер с документом и сам исправляет безопасные расхождения: возвращает вернувшиеся ноды на шарды и дожимает служебные версии. Настройка — cluster_config.auto_repair, по умолчанию включено.
Состояние контура показывает строка reconciler на странице Status.
| Состояние | Значение |
|---|---|
disabled | Выключено в конфигурации. |
standby | Нода не лидер _meta, контур работает на другой ноде. |
idle | Расхождений нет. |
waiting | Расхождение есть, контур выжидает. |
blocked | Контур не может действовать без оператора. |
running | Выполняется ремонт. |
error | Ошибка контура. |
Причины, которые требуют внимания:
| Причина | Значение | Что делать |
|---|---|---|
staged_latest | Есть сохранённая, но не применённая версия. Пока она висит, авто-восстановление заблокировано. | Примените или отмените версию баннером на странице Status. |
failed_execution | Применение версии завершилось ошибкой. | Посмотрите план версии, устраните причину и примените заново. |
quorum_lost | Шард потерял кворум. Авто-восстановление его не трогает. | Верните ноды. См. Здоровье Raft-групп. |
unknown_health | Здоровье нод ещё не известно. | Подождите. |
stability_window | Нода вернулась недавно. Контур ждёт, пока она стабильно проживёт stability_window, по умолчанию 60 секунд. | Подождите. |
cooldown | Недавно был ремонт. Контур выдерживает паузу cooldown, по умолчанию 5 минут. | Подождите. |
missing_replica | Не хватает реплики, контур её восстановит. | Подождите. |
policy_rejected | Нужный ремонт вне списка безопасных действий. | Выполните изменение вручную. |